News
- 12/2024: 😇😇Start my PhD journey at the University of Trento, fighting step by step.
- 11/2024: 🎉🎉Finished my journey in BAAI. Great thanks to my advisors Zheng Liu and Bo Zhao.
- 12/2023: 😄😄Ended my RA at CAS. Great thanks to my advisor Yu Zhou.
- 06/2023: 🎉🎉Got my Master`s Degree at HIT. Great thanks to my advisor Shaohui Liu.
|
Research
I work on multimodal LLMs that reason over long-form, information-dense inputs across modalities — from hour-scale video to high-resolution imagery and dense visual text. Below are some selected publications. (* indicates equal contribution.)
|
|
|
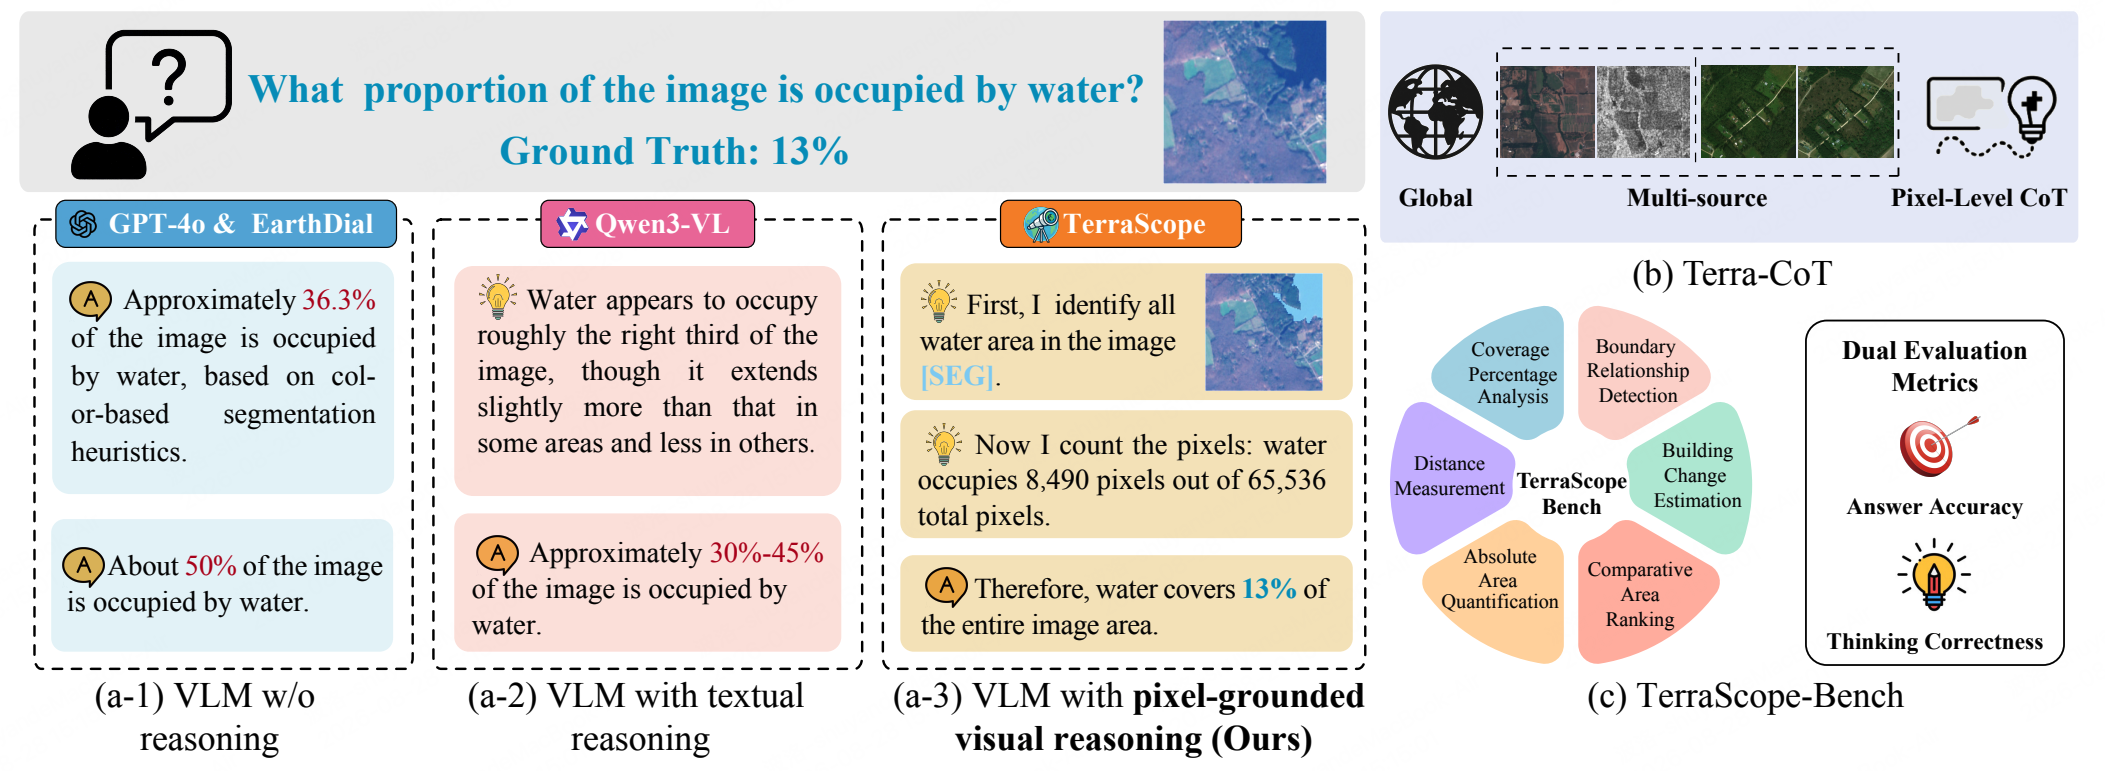
TerraScope: Pixel-Grounded Visual Reasoning for Earth Observation
Yan Shu,
Bin Ren,
Zhitong Xiong,
Xiao Xiang Zhu,
Begüm Demir,
Nicu Sebe,
Paolo Rota
CVPR, 2026
project page /
Arxiv
Pixel-grounded geospatial reasoning, with the Terra-CoT dataset and TerraScope-Bench.
|
|
|
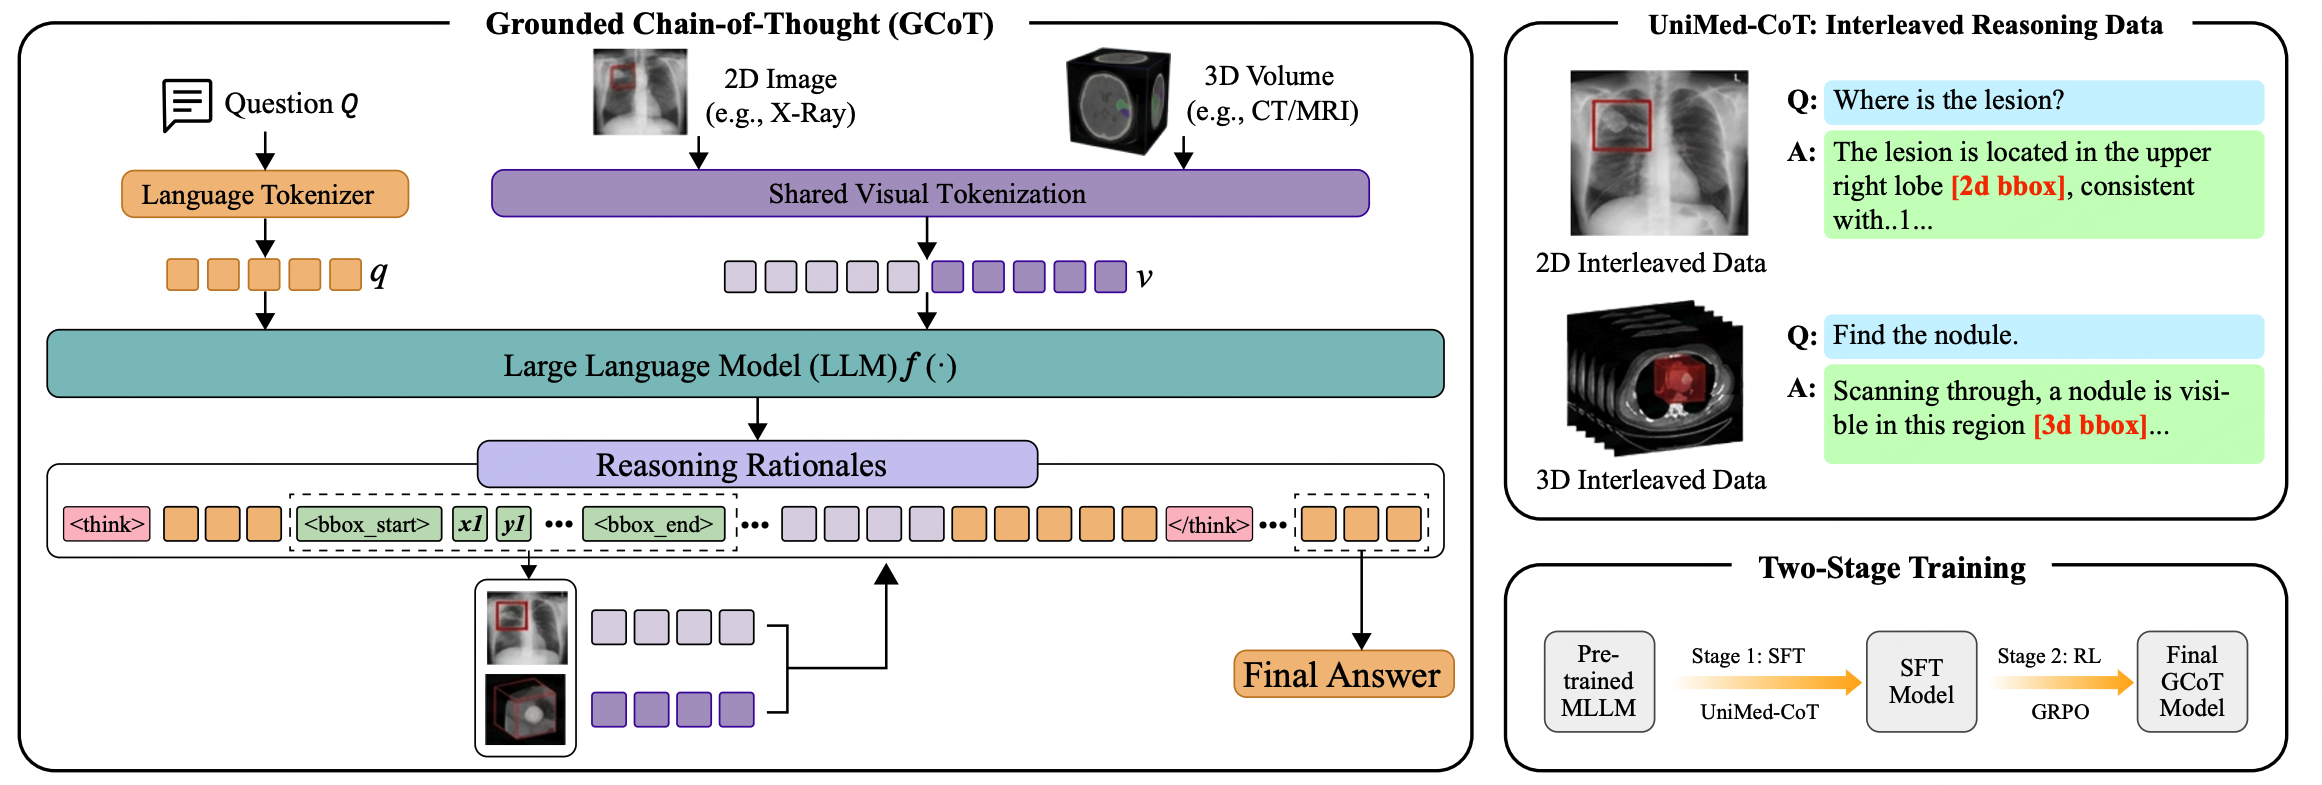
UniReason-Med: A Shared Grounded Reasoning Interface for 2D-to-3D Transfer in Medical VQA
Mengzhuo Chen*,
Yan Shu*,
Chi Liu,
Hongming Piao,
Xidong Wang,
Derek Li,
Bryan Dai
EMNLP, 2026 (Main)
project page /
Arxiv
A shared grounded reasoning interface that transfers 2D supervision to 3D medical VQA.
|
|
|
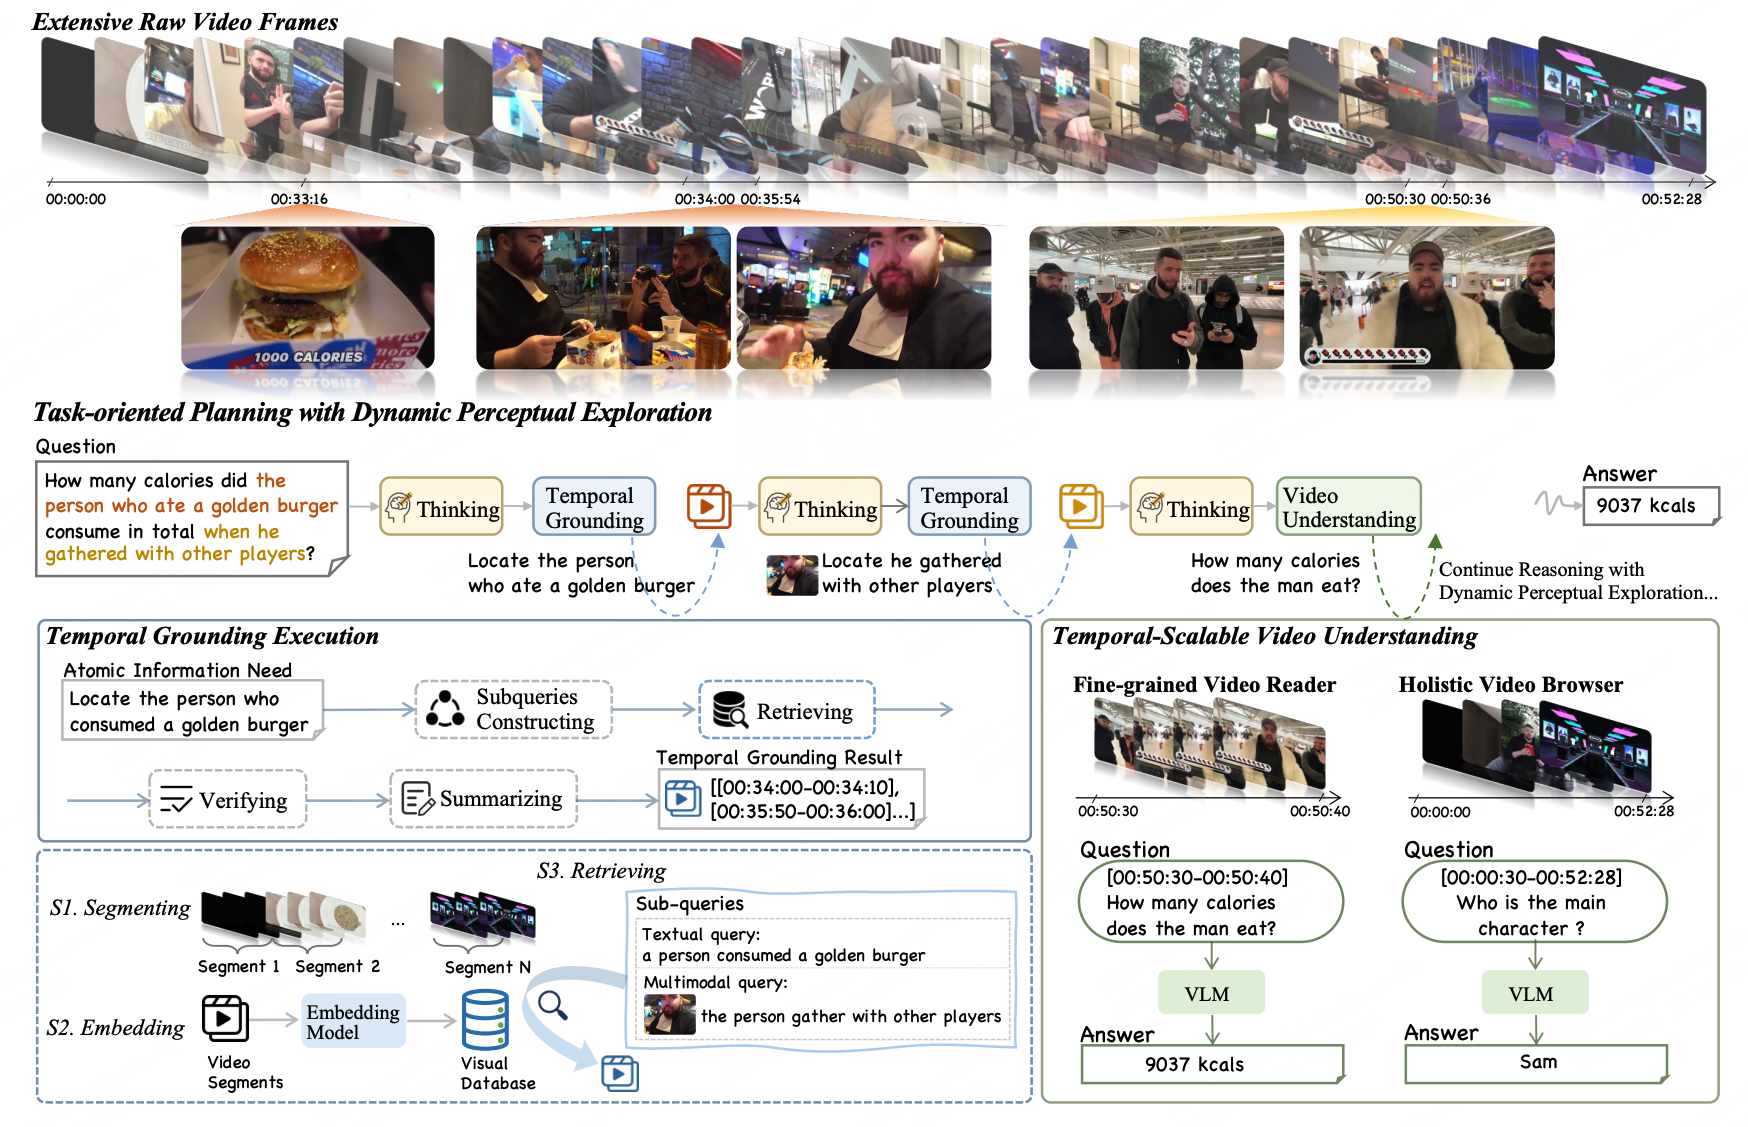
TimeScope: Towards Task-Oriented Temporal Grounding in Long Videos
Xiangrui Liu*,
Minghao Qin*,
Yan Shu*,
Zhengyang Liang,
Yang Tian,
Chen Jason Zhang,
Bo Zhao,
Zheng Liu
EMNLP, 2026 (Main)
Arxiv
Task-oriented temporal grounding in long videos, with the ToTG-Bench benchmark.
|
|
|
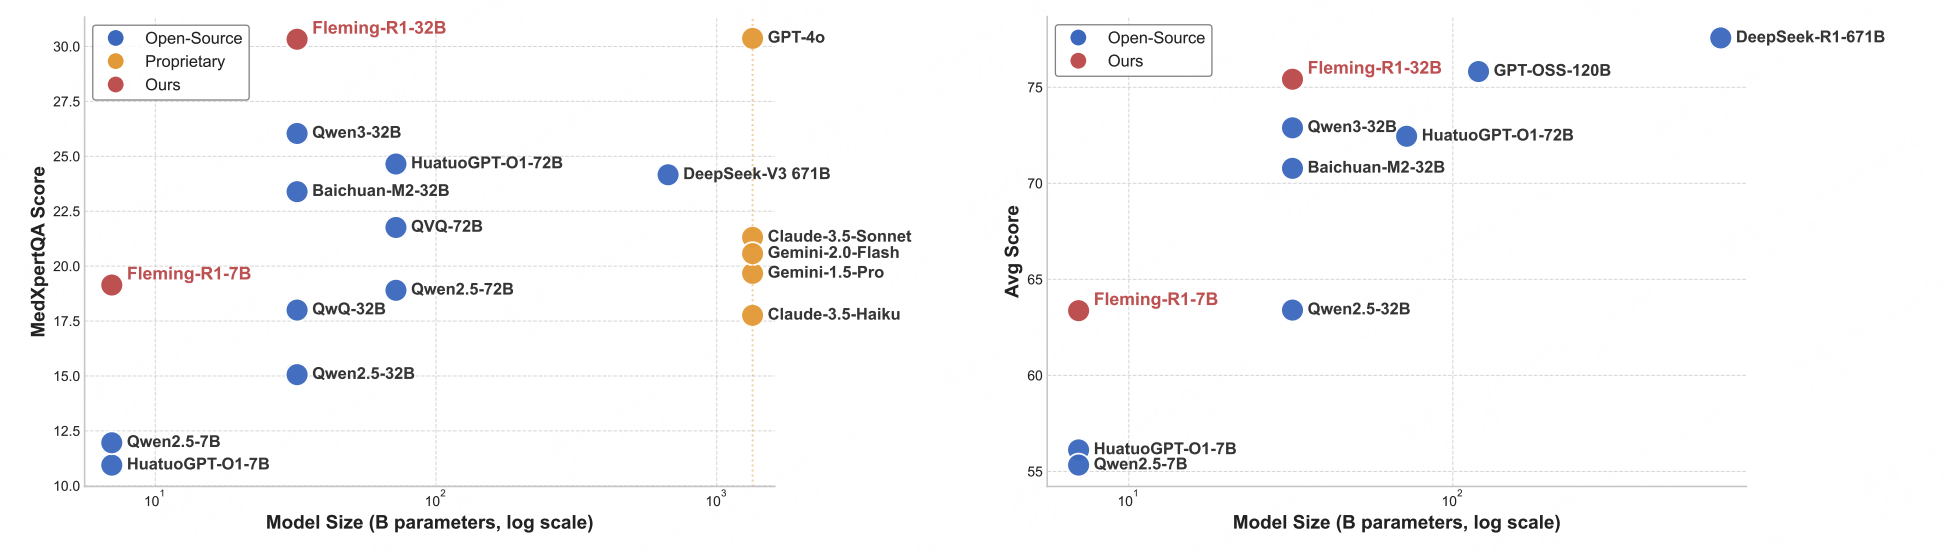
Scaling is Not All You Need: Clinical-Oriented Reinforcement Learning Makes Parameter-Efficient Clinical Reasoning
Chi Liu,
Yan Shu,
Mengzhuo Chen,
Hongming Piao,
Zhijian Duan,
Derek Li,
Bryan Dai
ACL Findings, 2026
project page /
ACL Anthology
Clinical-oriented RL that makes small models strong clinical reasoners.
|
|
|
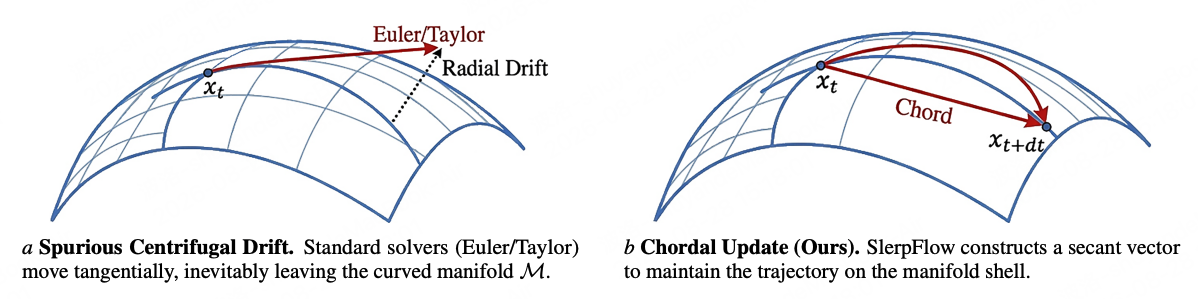
SlerpFlow: Spherical Trajectory Correction for Rectified Flow Inversion
Wenbin Duan,
Yan Shu,
Zhuoyuan Fu,
Fangmin Zhao,
Yan Li,
Yaru Zhao,
Binyang Li
ICML, 2026
project page
Spherical trajectory correction for stable rectified flow inversion and editing.
|
|
|
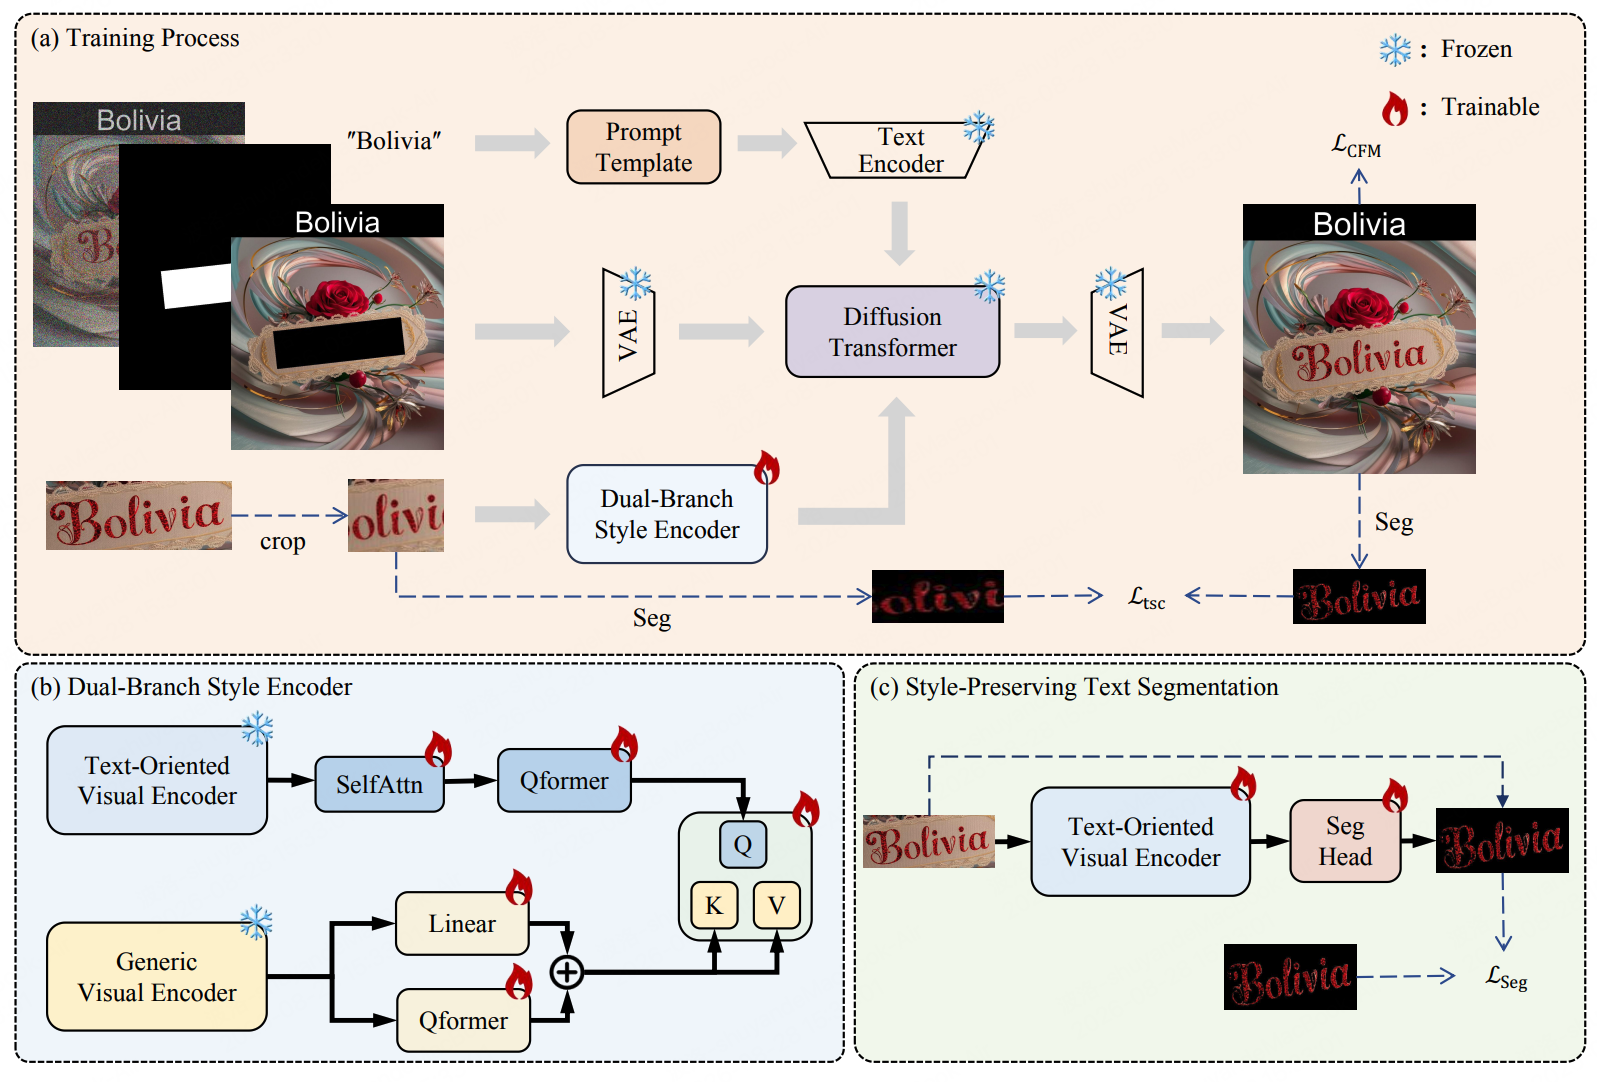
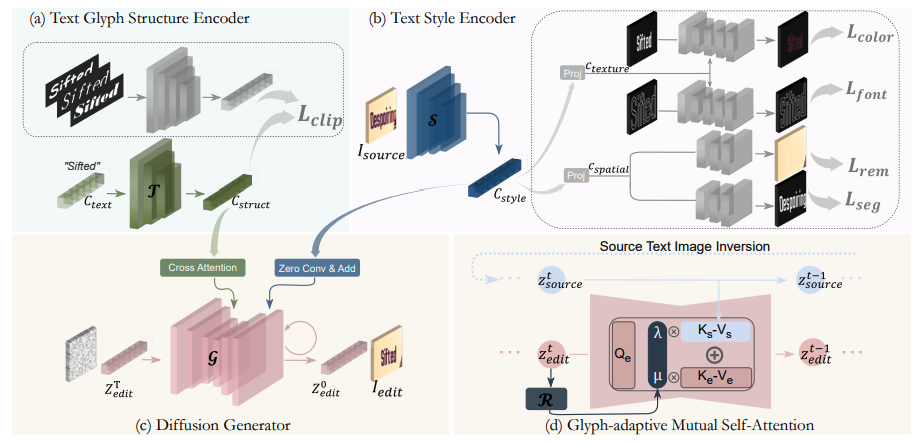
StyleTextGen: Style-Conditioned Multilingual Scene Text Generation
Zeyu Chen,
Fangmin Zhao,
Yan Shu,
Yichao Liu,
Liu Yu,
Yu Zhou
CVPR, 2026
paper /
Arxiv
Style-conditioned generation of multilingual scene text images.
|
|
|
VideoExplorer: Think With Videos For Agentic Long-Video Understanding
Huaying Yuan,
Zheng Liu,
Junjie Zhou,
Hongjin Qian,
Yan Shu,
Nicu Sebe,
Ji-Rong Wen,
Zhicheng Dou
KDD, 2026
project page /
Arxiv
An agentic framework that reasons with videos for long-video understanding.
|
|
|
VidText: Towards Comprehensive Evaluation for Video Text Understanding
Zhoufaran Yang,
Yan Shu,
Jing Wang,
Zhifei Yang,
Yan Zhang,
Yu Li,
Keyang Lu,
Gangyan Zeng,
Shaohui Liu,
Yu Zhou,
Nicu Sebe
CVPRW, 2026
project page /
Arxiv
A comprehensive benchmark for video text understanding.
|
|
|
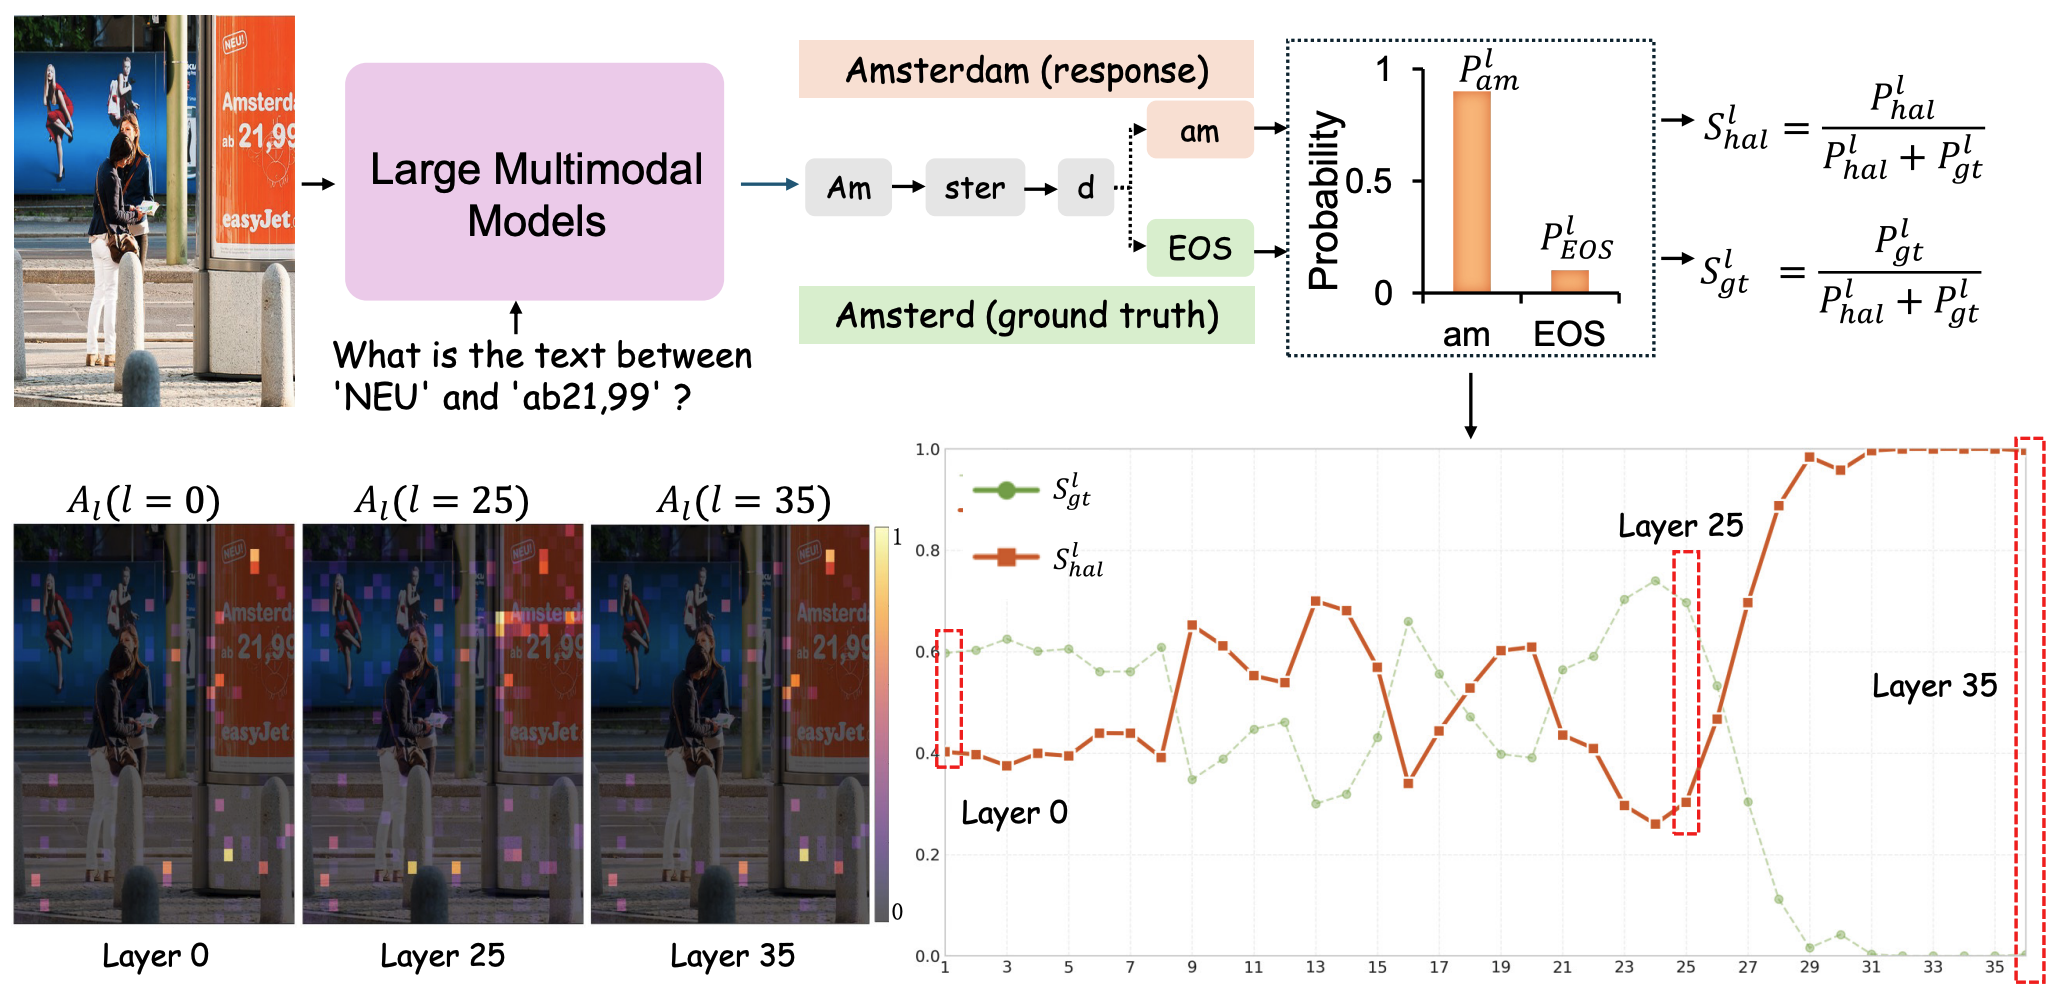
When Semantics Mislead Vision: Mitigating Large Multimodal Models Hallucinations in Scene Text Spotting and Understanding
Yan Shu*,
Hangui Lin*,
Yexin Liu*,
Yan Zhang,
Gangyan Zeng,
Yan Li,
Yu Zhou,
Ser-Nam Lim,
Harry Yang,
Nicu Sebe,
NeurIPS, 2025
project page /
Arxiv
Exploring and mitigating semantic hallucination in MLLMs.
|
|
|
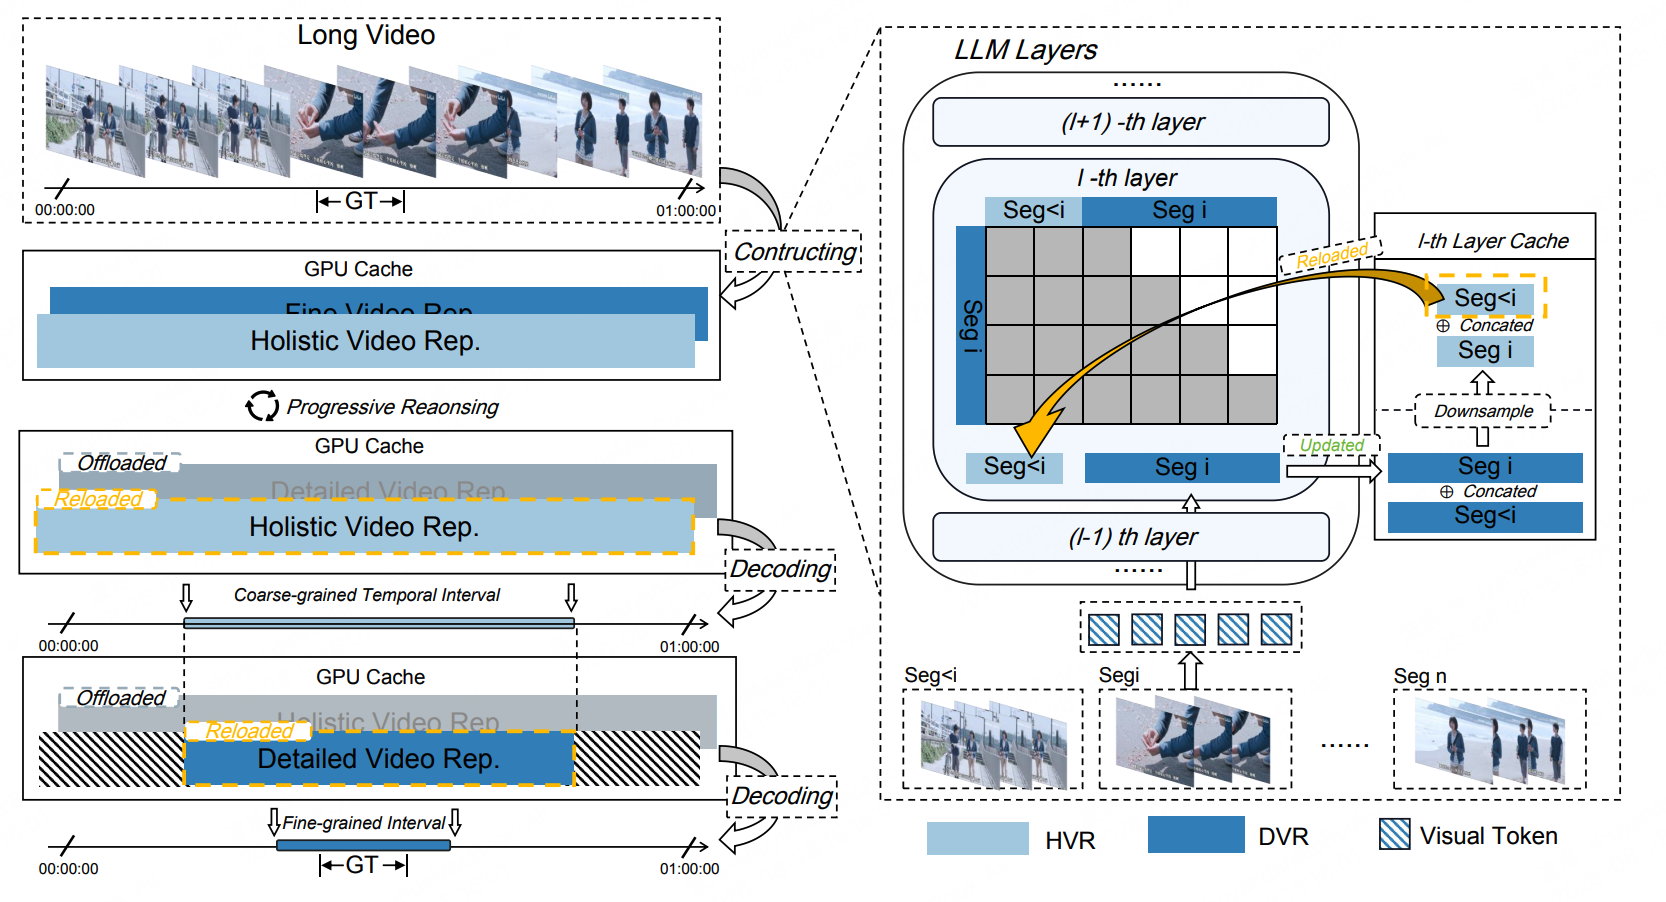
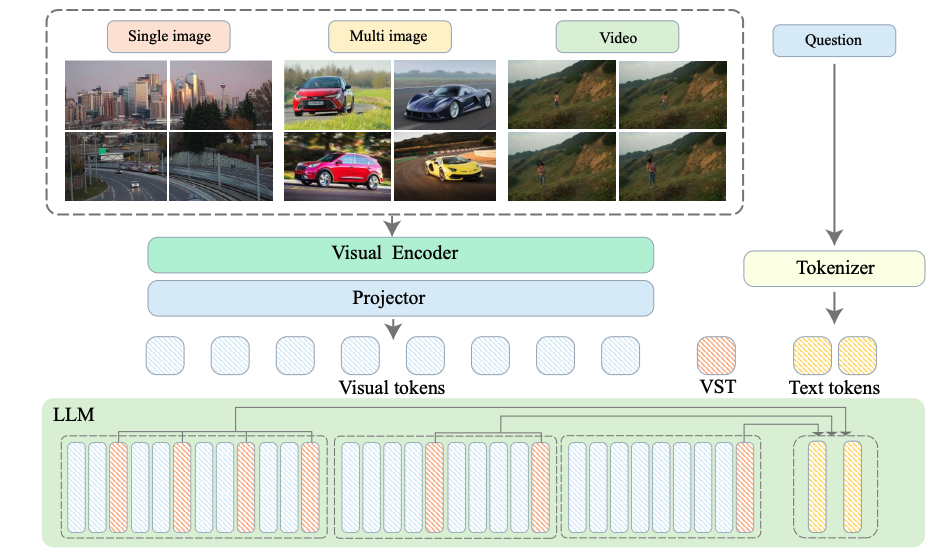
Video-XL: Extra-Long Vision Language Model for Hour-Scale Video Understanding
Yan Shu,
Peitian Zhang,
Zheng Liu,
Minghao Qin,
Junjie Zhou,
Tiejun Huang,
Bo Zhao
CVPR, 2025
(Oral)
project page /
Arxiv
First-ever hour-scale video understanding models.
|
|
|
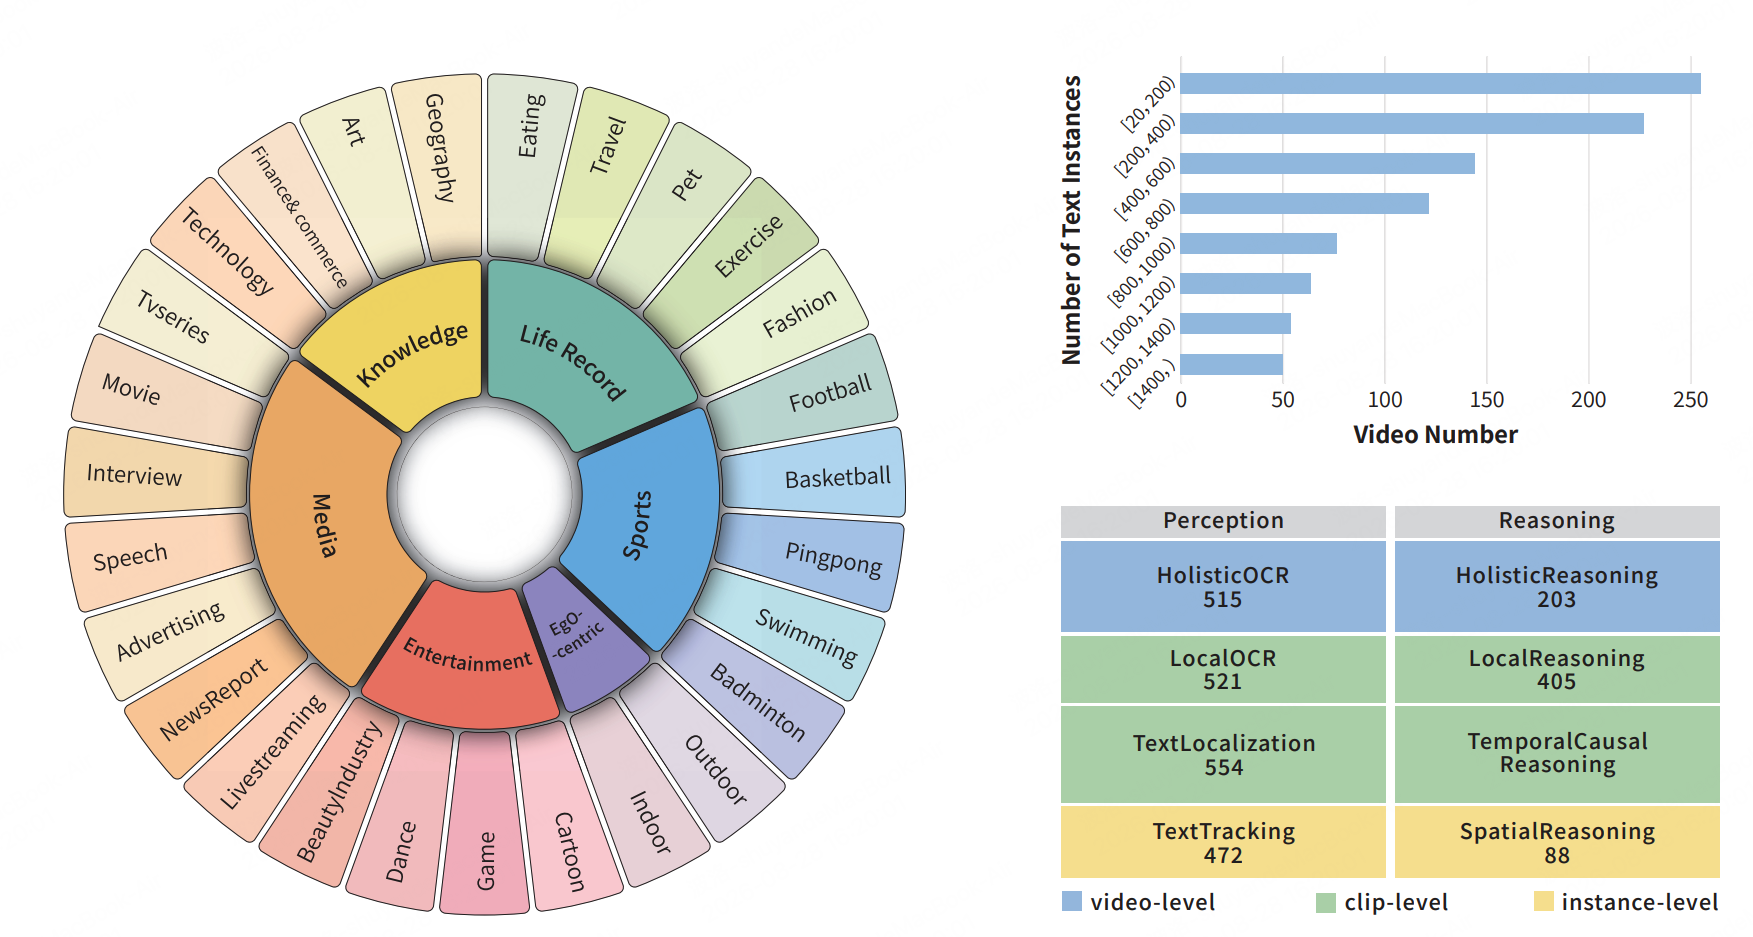
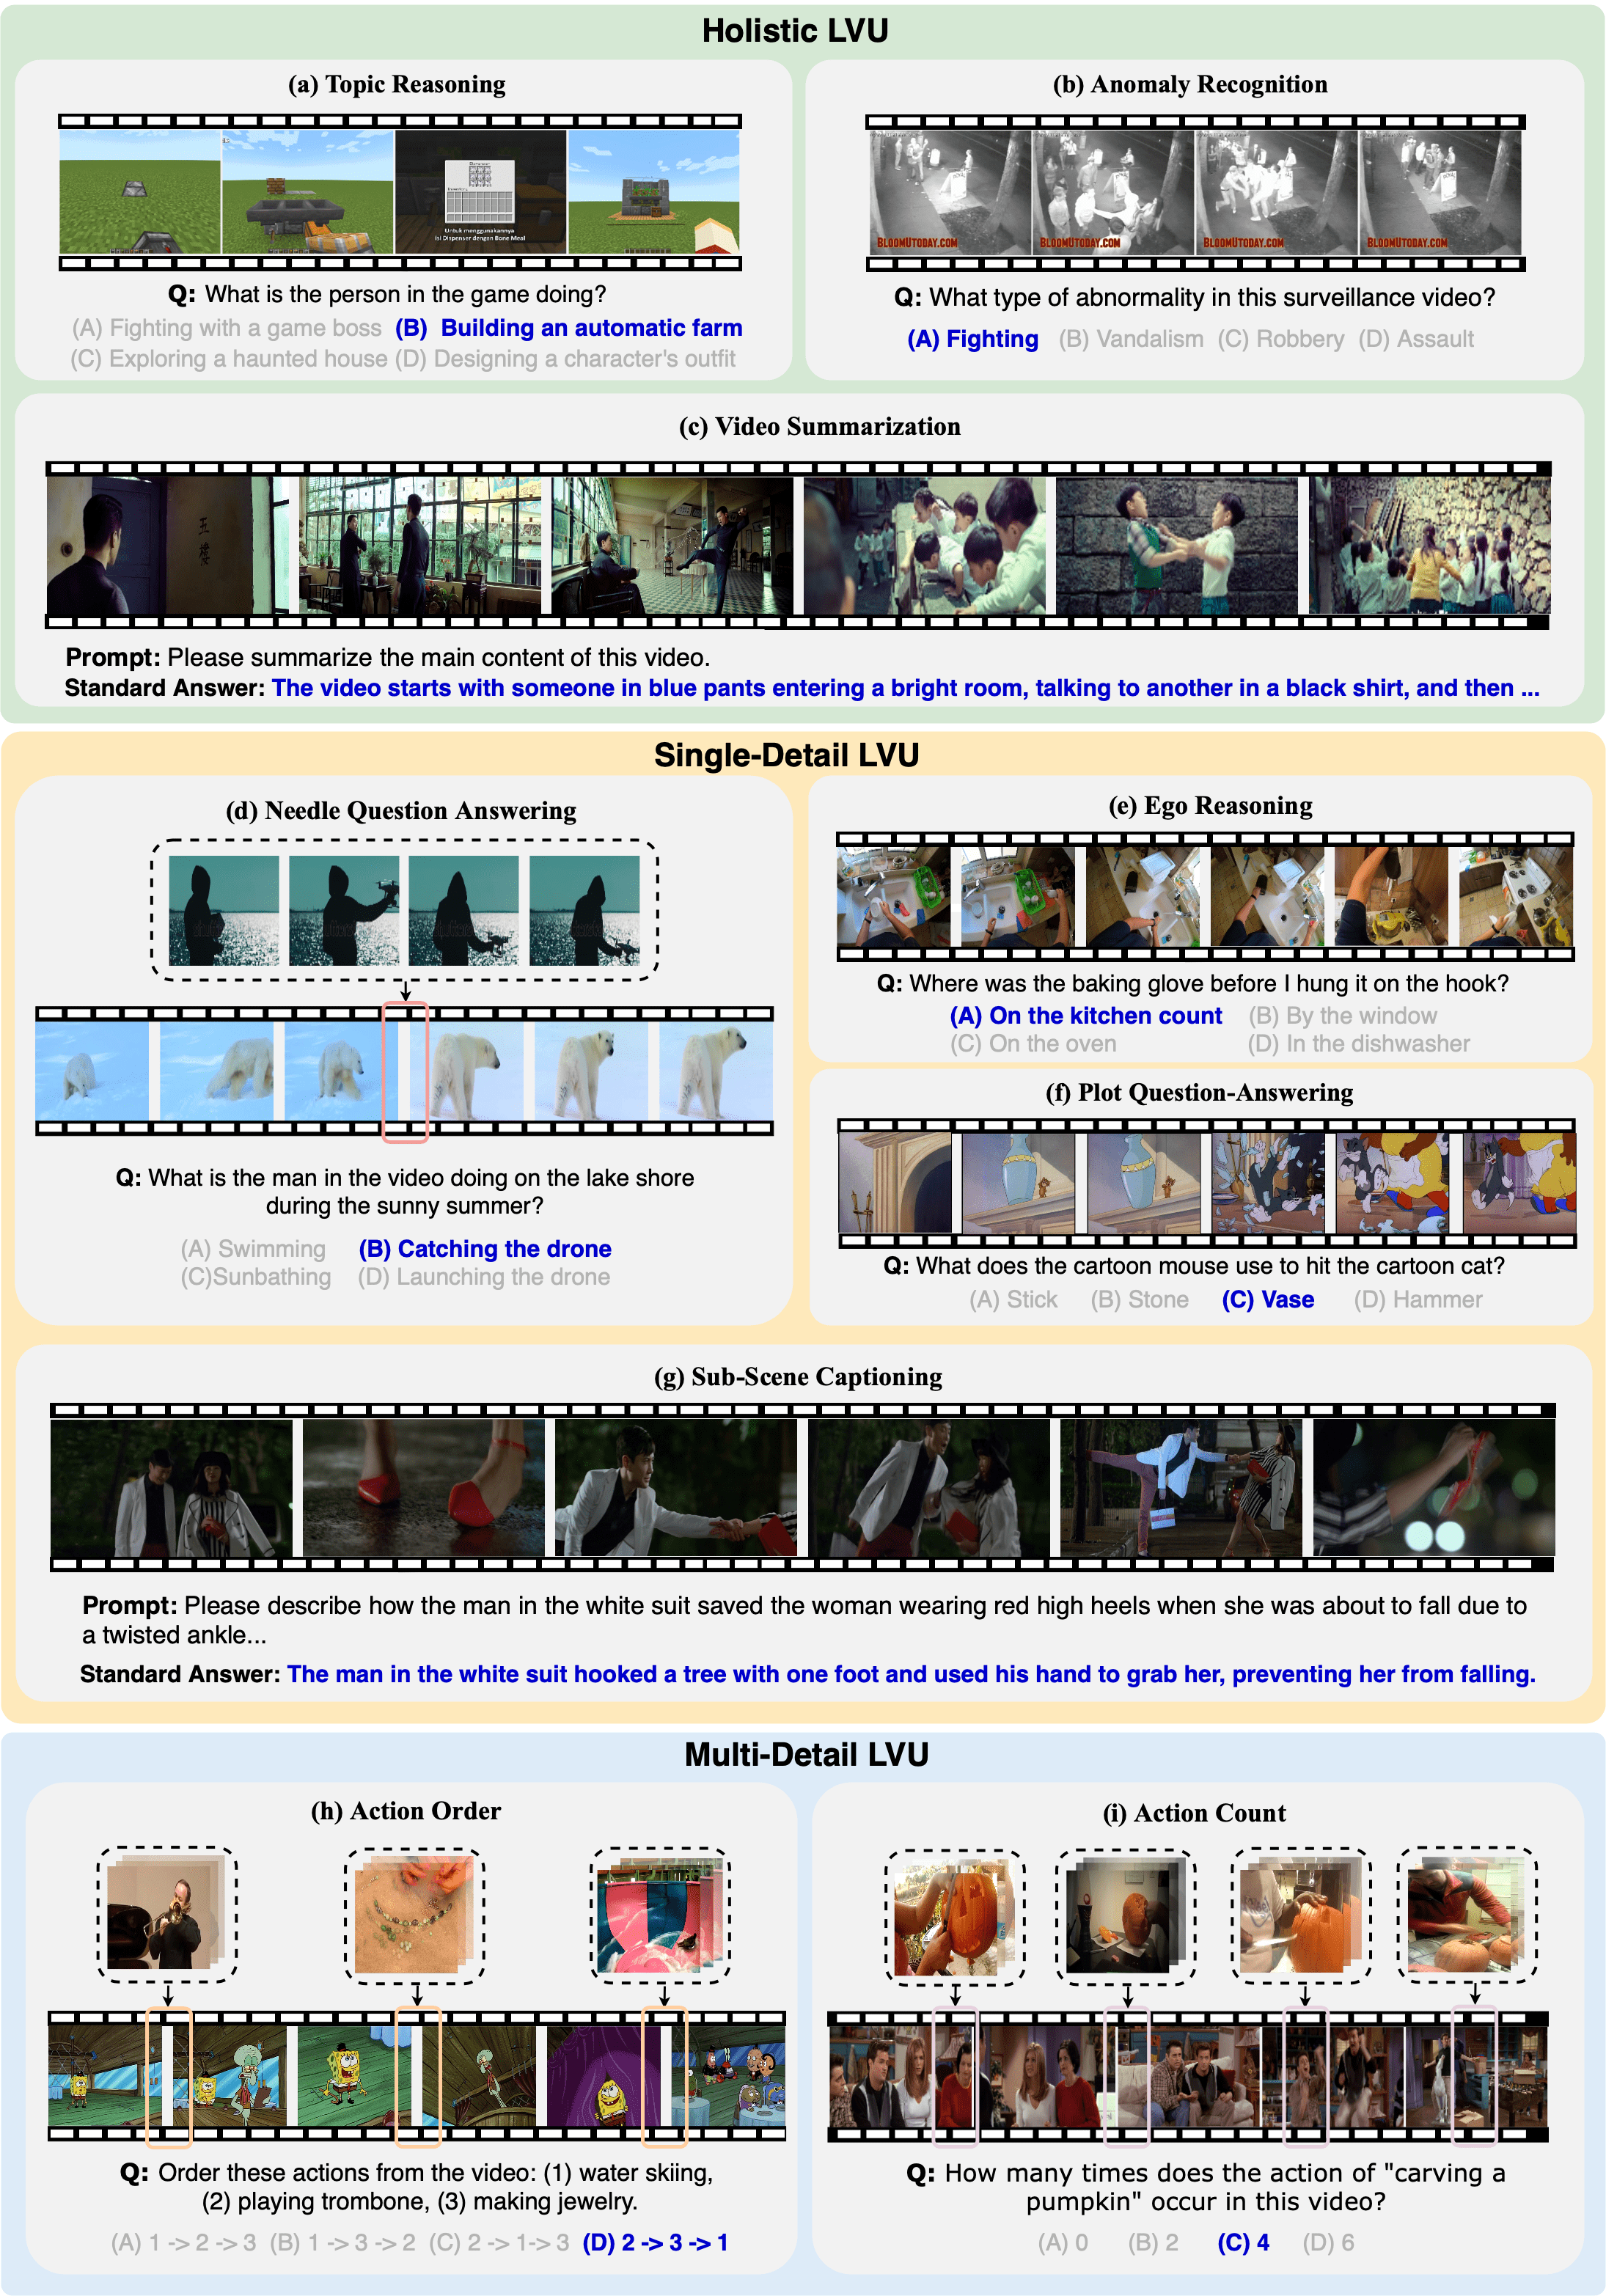
MLVU: Multi-task Long Video Understanding Benchmark
Junjie Zhou*,
Yan Shu*,
Bo Zhao*,
Boya Wu,
Shitao Xiao,
Xi Yang,
Yongping Xiong,
Bo Zhang,
Tiejun Huang,
Zheng Liu
CVPR, 2025
project page /
Arxiv
First-ever comprehensive long video benchmark.
|
|
|
TextCtrl: Diffusion-based Scene Text Editing with Prior Guidance Control
Weichao Zeng,
Yan Shu,
Zhenhang Li,
Dongbao Yang,
Yu Zhou
NeurIPS, 2024
(Spotlight)
project page /
arXiv
A diffusion-based scene text editing model as well as a real-world scene text editing benchmark.
|
|
|
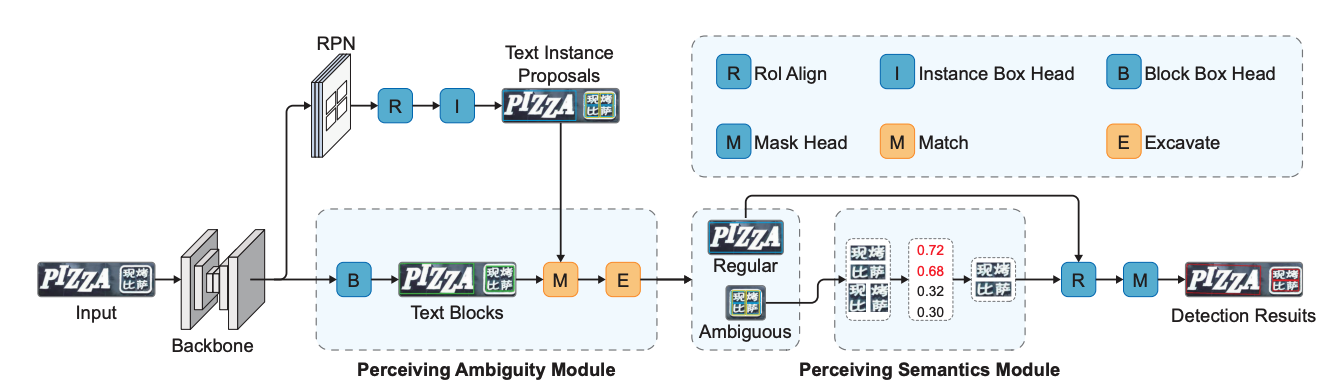
Perceiving Ambiguity and Semantics without Recognition: An Efficient and Effective Ambiguous Scene Text Detector
Yan Shu,
Wei Wang,
Yu Zhou,
Shaohui Liu,
Aoting Zhang,
Dongbao Yang,
Weiping Wang
ACM MM, 2023
(Oral)
project page /
arXiv
A model designed for ambiguous scene text detection.
|
Talks
- 12/2025: Give a talk about Semantic Halluciantion in MLLMs on CSIG(中国图像图形学会)
- 12/2024: Give a talk about Video-XL on 智源学者论坛
- 11/2024: Give a talk on Video LLMs at Renmin University invited by Prof. Ruihua Song
|
Education and Working Experience
|
|